概述 在默认情况下,一个Pod在哪个Node节点上运行,是由Scheduler组件采用相应的算法计算出来的,这个过程是不受人工控制的。
自动调度:运行在哪个Node节点上完全由Scheduler经过一系列的算法计算得出。
定向调度:NodeName、NodeSelector。
亲和性调度:NodeAffinity、PodAffinity、PodAntiAffinity。
污点(容忍)调度:Taints、Toleration。
定向调度 概述 定向调度,指的是利用在Pod上声明的nodeName或nodeSelector,以此将Pod调度到期望的Node节点上。强制的,这就意味着即使要调度的目标Node不存在,也会向上面进行调度,只不过Pod运行失败而已。
nodeName nodeName用于强制约束将Pod调度到指定的name的Node节点上。
创建一个pod-nodename.yaml文件,内容如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
apiVersion: v1 kind: Pod metadata: name: pod-nodename namespace: dev spec: containers: - name: nginx image: nginx:1.17.1 imagePullPolicy: IfNotPresent ports: - name: nginx-port containerPort: 80 protocol: TCP nodeName: k8s-node1
1
2
3
4
kubectl create -f pod-nodename.yaml # 查看 kubectl get pod pod-nodename -n dev -o wide
nodeSelector nodeSelector用于将Pod调度到添加了指定标签的Node节点上,它是通过kubernetes的label-selector机制实现的,强制约束。
1
2
3
# 首先给node节点添加标签 kubectl label node k8s-node1 nodeenv=pro kubectl label node k8s-node2 nodeenv=test
创建pod-nodeselector.yaml文件,内容如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
apiVersion: v1 kind: Pod metadata: name: pod-nodeselector namespace: dev spec: containers: - name: nginx image: nginx:1.17.1 imagePullPolicy: IfNotPresent ports: - name: nginx-port containerPort: 80 protocol: TCP nodeSelector: nodeenv: pro
1
2
3
4
kubectl create -f pod-nodeselector.yaml # 查看 kubectl get pod pod-nodeselector -n dev -o wide
亲和性调度 概述 虽然定向调度的两种方式,使用起来非常方便,但是也有一定的问题,那就是如果没有满足条件的Node,那么Pod将不会被运行,即使在集群中还有可用的Node列表也不行,这就限制了它的使用场景。
nodeAffinity(node亲和性):以Node为目标,解决Pod可以调度到那些Node的问题。
podAffinity(pod亲和性):以Pod为目标,解决Pod可以和那些已存在的Pod部署在同一个拓扑域中的问题。
podAntiAffinity(pod反亲和性):以Pod为目标,解决Pod不能和那些已经存在的Pod部署在同一拓扑域中的问题。
关于亲和性和反亲和性的使用场景的说明:
亲和性:如果两个应用频繁交互,那么就有必要利用亲和性让两个应用尽可能的靠近,这样可以较少因网络通信而带来的性能损耗。
反亲和性:当应用采用多副本部署的时候,那么就有必要利用反亲和性让各个应用实例打散分布在各个Node上,这样可以提高服务的高可用性。
nodeAffinity nodeAffinity的可选配置项:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
pod.spec.affinity.nodeAffinity requiredDuringSchedulingIgnoredDuringExecution Node节点必须满足指定的所有规则才可以,相当于硬限制 nodeSelectorTerms 节点选择列表 matchFields 按节点字段列出的节点选择器要求列表 matchExpressions 按节点标签列出的节点选择器要求列表(推荐) key 键 values 值 operator 关系符 支持Exists, DoesNotExist, In, NotIn, Gt, Lt preferredDuringSchedulingIgnoredDuringExecution 优先调度到满足指定的规则的Node,相当于软限制 (倾向) preference 一个节点选择器项,与相应的权重相关联 matchFields 按节点字段列出的节点选择器要求列表 matchExpressions 按节点标签列出的节点选择器要求列表(推荐) key 键 values 值 operator 关系符 支持In, NotIn, Exists, DoesNotExist, Gt, Lt weight 倾向权重,在范围1-100。
关系符的使用说明:
1
2
3
4
5
6
7
8
9
- matchExpressions: - key: nodeenv operator: Exists - key: nodeenv operator: In values: ["xxx" ,"yyy" ] - key: nodeenv operator: Gt values: "xxx"
requiredDuringSchedulingIgnoredDuringExecution 创建pod-nodeaffinity-required.yaml文件,内容如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
apiVersion: v1 kind: Pod metadata: name: pod-nodeaffinity-required namespace: dev spec: containers: - name: nginx image: nginx:1.17.1 imagePullPolicy: IfNotPresent ports: - name: nginx-port containerPort: 80 protocol: TCP affinity: nodeAffinity: requiredDuringSchedulingIgnoredDuringExecution: nodeSelectorTerms: - matchExpressions: - key: nodeenv operator: In values: - "xxx" - "yyy"
1
2
3
4
5
6
7
8
9
10
kubectl create -f pod-nodeaffinity-required.yaml # 查看Pod状态(运行失败) kubectl get pod pod-nodeaffinity-required -n dev -o wide # 查看Pod详情(发现调度失败,提示node选择失败): kubectl describe pod pod-nodeaffinity-required -n dev # 删除pod kubectl delete -f pod-nodeaffinity-required.yaml
修改pod-nodeaffinity-required.yaml文件,内容如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
apiVersion: v1 kind: Pod metadata: name: pod-nodeaffinity-required namespace: dev spec: containers: - name: nginx image: nginx:1.17.1 imagePullPolicy: IfNotPresent ports: - name: nginx-port containerPort: 80 protocol: TCP affinity: nodeAffinity: requiredDuringSchedulingIgnoredDuringExecution: nodeSelectorTerms: - matchExpressions: - key: nodeenv operator: In values: - "pro" - "yyy"
1
2
3
4
kubectl create -f pod-nodeaffinity-required.yaml # 查看pod kubectl get pod pod-nodeaffinity-required -n dev -o wide
preferredDuringSchedulingIgnoredDuringExecution 创建pod-nodeaffinity-preferred.yaml文件,内容如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
apiVersion: v1 kind: Pod metadata: name: pod-nodeaffinity-preferred namespace: dev spec: containers: - name: nginx image: nginx:1.17.1 imagePullPolicy: IfNotPresent ports: - name: nginx-port containerPort: 80 protocol: TCP affinity: nodeAffinity: preferredDuringSchedulingIgnoredDuringExecution: - preference: matchExpressions: - key: nodeenv operator: In values: - "xxx" - "yyy" weight: 1
1
2
3
kubectl create -f pod-nodeaffinity-preferred.yaml kubectl get pod pod-nodeaffinity-preferred -n dev -o wide
nodeAffinity的注意事项:
如果同时定义了nodeSelector和nodeAffinity,那么必须两个条件都满足,Pod才能运行在指定的Node上。
如果nodeAffinity指定了多个nodeSelectorTerms,那么只需要其中一个能够匹配成功即可。
如果一个nodeSelectorTerms中有多个matchExpressions,则一个节点必须满足所有的才能匹配成功。
如果一个Pod所在的Node在Pod运行期间其标签发生了改变,不再符合该Pod的nodeAffinity的要求,则系统将忽略此变化。
podAffinity podAffinity主要实现以运行的Pod为参照,实现让新创建的Pod和参照的Pod在一个区域的功能。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
pod.spec.affinity.podAffinity requiredDuringSchedulingIgnoredDuringExecution 硬限制 namespaces 指定参照pod的namespace topologyKey 指定调度作用域 labelSelector 标签选择器 matchExpressions 按节点标签列出的节点选择器要求列表(推荐) key 键 values 值 operator 关系符 支持In, NotIn, Exists, DoesNotExist. matchLabels 指多个matchExpressions映射的内容 preferredDuringSchedulingIgnoredDuringExecution 软限制 podAffinityTerm 选项 namespaces topologyKey labelSelector matchExpressions key 键 values 值 operator matchLabels weight 倾向权重,在范围1-100
topologyKey用于指定调度的作用域,例如:
如果指定为kubernetes.io/hostname,那就是以Node节点为区分范围。
如果指定为beta.kubernetes.io/os,则以Node节点的操作系统类型来区分。
requiredDuringSchedulingIgnoredDuringExecution 创建pod-podaffinity-target.yaml文件,内容如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
apiVersion: v1 kind: Pod metadata: name: pod-podaffinity-target namespace: dev labels: podenv: pro spec: containers: - name: nginx image: nginx:1.17.1 imagePullPolicy: IfNotPresent ports: - name: nginx-port containerPort: 80 protocol: TCP nodeName: k8s-node1
1
2
3
4
kubectl create -f pod-podaffinity-target.yaml # 查看参照Pod kubectl get pod pod-podaffinity-target -n dev -o wide
创建pod-podaffinity-requred.yaml文件,内容如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
apiVersion: v1 kind: Pod metadata: name: pod-podaffinity-requred namespace: dev spec: containers: - name: nginx image: nginx:1.17.1 imagePullPolicy: IfNotPresent ports: - name: nginx-port containerPort: 80 protocol: TCP affinity: podAffinity: requiredDuringSchedulingIgnoredDuringExecution: - labelSelector: matchExpressions: - key: podenv operator: In values: - "xxx" - "yyy" topologyKey: kubernetes.io/hostname
1
2
3
4
5
6
7
8
9
10
kubectl create -f pod-podaffinity-requred.yaml # 查看Pod状态,发现没有运行: kubectl get pod pod-podaffinity-requred -n dev # 查看Pod详情: kubectl get pod pod-podaffinity-requred -n dev # 删除Pod kubectl delete -f pod-podaffinity-requred.yaml
修改pod-podaffinity-requred.yaml文件,内容如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
apiVersion: v1 kind: Pod metadata: name: pod-podaffinity-requred namespace: dev spec: containers: - name: nginx image: nginx:1.17.1 imagePullPolicy: IfNotPresent ports: - name: nginx-port containerPort: 80 protocol: TCP affinity: podAffinity: requiredDuringSchedulingIgnoredDuringExecution: - labelSelector: matchExpressions: - key: podenv operator: In values: - "pro" - "yyy" topologyKey: kubernetes.io/hostname
1
2
3
4
kubectl create -f pod-podaffinity-requred.yaml # 再次查看Pod kubectl get pod pod-podaffinity-requred -n dev -o wide
podAntiAffinity podAntiAffinity主要实现以运行的Pod为参照,让新创建的Pod和参照的Pod不在一个区域的功能。
1 kubectl get pod -n dev -o wide
创建pod-podantiaffinity-requred.yaml文件,内容如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
apiVersion: v1 kind: Pod metadata: name: pod-podantiaffinity-requred namespace: dev spec: containers: - name: nginx image: nginx:1.17.1 imagePullPolicy: IfNotPresent ports: - name: nginx-port containerPort: 80 protocol: TCP affinity: podAntiAffinity: requiredDuringSchedulingIgnoredDuringExecution: - labelSelector: matchExpressions: - key: podenv operator: In values: - "pro" topologyKey: kubernetes.io/hostname
1
2
3
4
kubectl create -f pod-podantiaffinity-requred.yaml # 查看 kubectl get pod -n dev -o wide
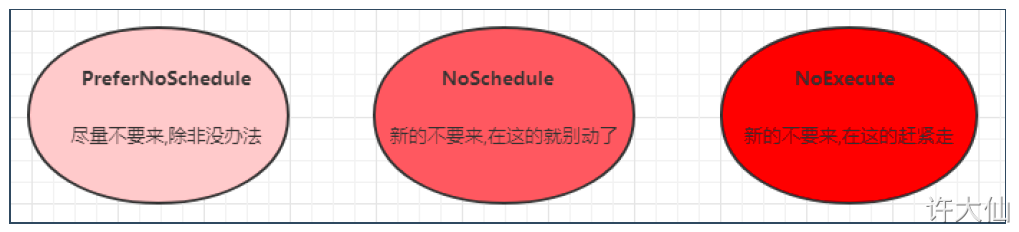
污点和容忍 污点(Taints) 前面的调度方式都是站在Pod的角度上,通过在Pod上添加属性,来确定Pod是否要调度到指定的Node上,其实我们也可以站在Node的角度上,通过在Node上添加污点属性,来决定是否运行Pod调度过来。key=value:effect,key和value是污点的标签,effect描述污点的作用,支持如下三个选项:
PreferNoSchedule:kubernetes将尽量避免把Pod调度到具有该污点的Node上,除非没有其他节点可以调度。
NoSchedule:kubernetes将不会把Pod调度到具有该污点的Node上,但是不会影响当前Node上已经存在的Pod。
NoExecute:kubernetes将不会把Pod调度到具有该污点的Node上,同时也会将Node上已经存在的Pod驱逐。
语法 1 2 3 4 5 6 7 8 9 10 11 # 设置污点 kubectl taint node xxx key=value:effect # 去除污点 kubectl taint node xxx key:effect- # 去除所有污点 kubectl taint node xxx key- # 查看指定节点上的污点: kubectl describe node 节点名称
接下来,演示污点效果:
① 准备节点k8s-node1(为了演示效果更加明显,暂时停止k8s-node2节点)。
② 为k8s-node1节点设置一个污点:tag=test:PreferNoSchedule,然后创建Pod1(Pod1可以)。
③ 修改k8s-node1节点的污点为:tag=test:NoSchedule,然后创建Pod2(Pod1可以正常运行,Pod2失败)。
④ 修改k8s-node1节点的污点为:tag=test:NoExecute,然后创建Pod3(Pod1、Pod2、Pod3失败)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 # 为k8s-node1设置污点(PreferNoSchedule) kubectl taint node k8s-node1 tag=xudaxian:PreferNoSchedule # 创建Pod1 kubectl run pod1 --image=nginx:1.17.1 -n dev # 查看Pod kubectl get pod pod1 -n dev -o wide # 为k8s-node1取消污点(PreferNoSchedule),并设置污点(NoSchedule) kubectl taint node k8s-node1 tag:PreferNoSchedule- kubectl taint node k8s-node1 tag=xudaxian:NoSchedule # 创建Pod2 kubectl run pod2 --image=nginx:1.17.1 -n dev # 查看Pod kubectl get pod pod1 -n dev -o wide kubectl get pod pod2 -n dev -o wide # 为k8s-node1取消污点(NoSchedule),并设置污点(NoExecute) kubectl taint node k8s-node1 tag:NoSchedule- kubectl taint node k8s-node1 tag=xudaxian:NoExecute # 创建Pod3 kubectl run pod3 --image=nginx:1.17.1 -n dev # 查看Pod kubectl get pod pod1 -n dev -o wide kubectl get pod pod2 -n dev -o wide kubectl get pod pod3 -n dev -o wide
使用kubeadm搭建的集群,默认就会给Master节点添加一个污点标记,所以Pod就不会调度到Master节点上。
容忍(Toleration) 上面介绍了污点的作用,我们可以在Node上添加污点用来拒绝Pod调度上来,但是如果就是想让一个Pod调度到一个有污点的Node上去,这时候应该怎么做?这就需要使用到容忍。
污点就是拒绝,容忍就是忽略,Node通过污点拒绝Pod调度上去,Pod通过容忍忽略拒绝。
容忍的详细配置:
1
2
3
4
5
6
7
8
kubectl explain pod.spec.tolerations ...... FIELDS: key value operator effect tolerationSeconds
当operator为Equal的时候,如果Node节点有多个Taint,那么Pod每个Taint都需要容忍才能部署上去。
1
2
3
4
tolerations: - key: "tag" operator: Exists effect: NoExecute
容忍指定的污点,不考虑具体的effect:
1
2
3
tolerations: - key: "tag" operator: Exists
容忍一切污点(慎用):
1
2
tolerations: - operator: Exists
在上面的污点中,已经给k8s-node1打上了NoExecute的污点,此时Pod是调度不上去的,此时可以通过在Pod中添加容忍,将Pod调度上去。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
apiVersion: v1 kind: Pod metadata: name: pod-toleration namespace: dev spec: containers: - name: nginx image: nginx:1.17.1 imagePullPolicy: IfNotPresent ports: - name: nginx-port containerPort: 80 protocol: TCP tolerations: - key: "tag" operator: Equal value: "test" effect: NoExecute
1
2
3
4
5
# 创建Pod kubectl create -f pod-toleration.yaml # 查看Pod kubectl get pod pod-toleration -n dev -o wide